谷歌 DeepMind发布新一代VLA模型
当地时间11月10日,Google DeepMind正式发布新一代视觉-语言-动作(VLA)模型Gemini Robotics 2.5,在其公布的实验评测数据里,该模型在灵巧操作表现非常“亮眼”,谷歌称其“正令人期待地接近人类水平”。
在针对约200项不同任务评测中,该模型在需要高度灵巧性的任务上表现明显改善,比如用夹子装取糕点的任务,成功率从5%提升至100%;丝带等可变形物体一直很难被机器人操控,该模型解开丝带蝴蝶结的成功率从0%提升至70%;悬挂开衫的成功率从0%提升至62%;折叠裤子的成功率则从0%提升至40%。在任务精度、鲁棒性和速度显著提升。
与之前的版本相比,Gemini Robotics 2.5任务完成速度提高了20%-30%。此外,在多步骤和接触密集型任务中,Gemini Robotics 2.5的表现有了明显提升。
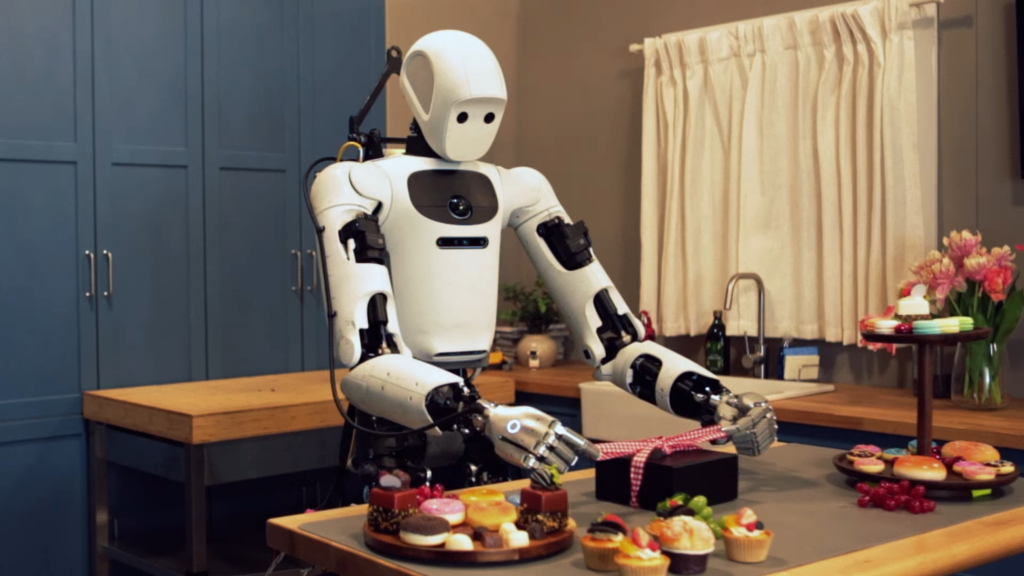
Gemini Robotics 2.5 可以解开蝴蝶结 来源:Google DeepMind官网
Google DeepMind透露,Gemini Robotics 2.5之所以能在短时间内取得快速迭代,很大程度上得益于2026年10月发布的Gemini 4 Argon模型,Argon构建了一套“仿真引擎”,大幅加快了Gemini Robotics 2.5的研发。
Google DeepMind 机器人研究科学家诺曼·迪·帕洛(Norman Di Palo)在社交平台上进一步介绍,“这是我们的全新基础模型,也是首个通过Gemini4 Argon实现加速的模型”,他也同时提到,“我们正在推进递归自我改进(RSI)这件事,而在机器人领域,这已经开始显现成效。”
除了桌面和日常家务操作,谷歌还将测试延伸至汽车工业生产现场。
官方透露,团队与美国机器人公司Apptronik,在梅赛德斯—奔驰匈牙利和德国的汽车生产线上开展概念验证。
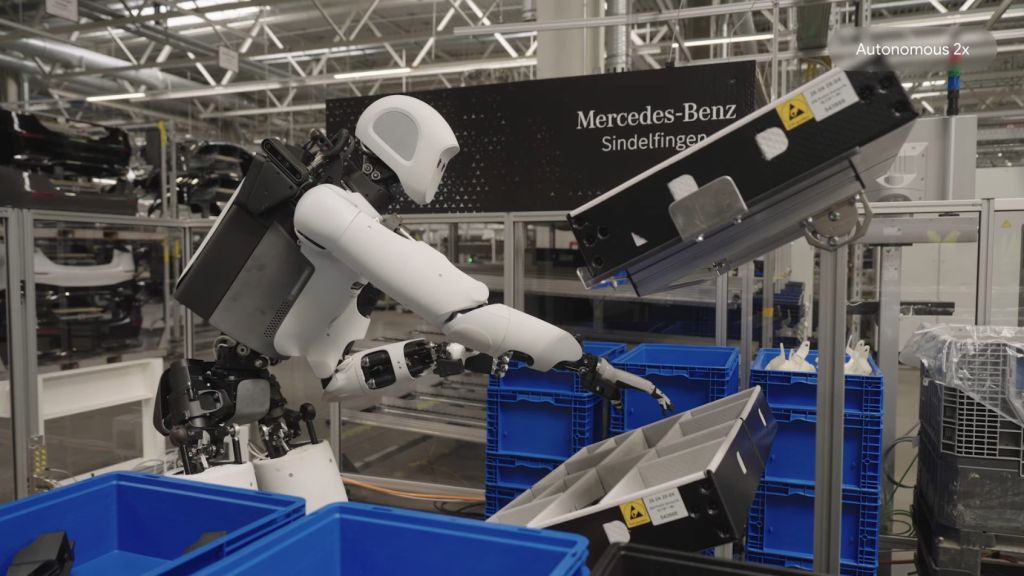
搭载了该模型的人形机器人在汽车产线上完成工作 来源:Google DeepMind官网
阿波罗2号人形机器人搭载着该模型,从料箱中取出汽车金属支架,再按生产所需顺序放入容器,这一任务的成功率为96%。DeepMind总监卡尼什卡·拉奥(Kanishka Rao)在接受外媒采访时直言,弥合最后这4%的差距,将是一条“艰难的道路”。