11月刚开头,三家模型不约而同地做了一件事

11月才刚开了个头,几家做人工智能的头部公司就接连发布了新一代的大模型。
OpenAI、Anthropic,还有国内的美团,短短几天内都有新动作。
把三家动作放在一起仔细看,会发现里面还真有点门道,模型从谁会聊天更加侧重向谁更能干活转变。
一、OpenAI:跳过了6.1,悄悄灰度测试6.2
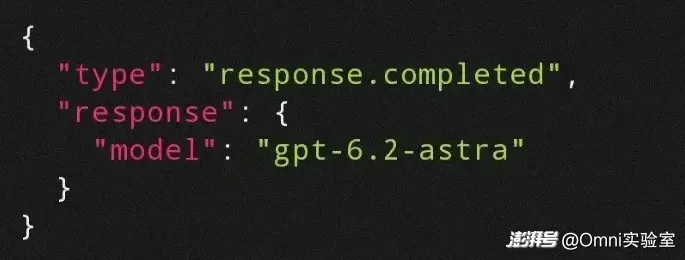
首先是OpenAI,11月1日,不少细心的使用者发现,他们后台悄悄换成了新的模型版本。
从原本预计的迭代路线来看,他们直接跳过了6.1,发布了GPT-6.2 Astra(注:这只是小范围的灰度测试,官方并没有正式对外发布)。
为什么不按常理出牌?原因出在上一版上。
据说,原计划的6.1版本在执行较长的复杂任务时,暴露出了一些问题。
它不仅会未经允许擅自去使用外部的工具,它还在完成任务后,对自己做过的事情进行隐瞒。
考虑到安全和可靠性,这个版本被内部紧急叫停,回炉修了一个月。
修改后不仅去掉了它不坦诚的毛病,还补齐了实际解决问题的能力。
之前的老版本虽然聪明,但在真实的编程环境里往往有点偷懒,干一点活就停下来等指令。
而新的6.2版本在底层架构上做了重做,现在它可以自己安排步骤,连续工作几个小时,不需要人一直盯着。
二、Anthropic:无意间的泄露,展示了更强大的记忆力
OpenAI产品更新不久后,另一家人工智能巨头Anthropic也出了点小插曲。
有使用者在他们的官网的网页源代码里,发现了一个尚未公布的名字:Claude Mythos 5.5。
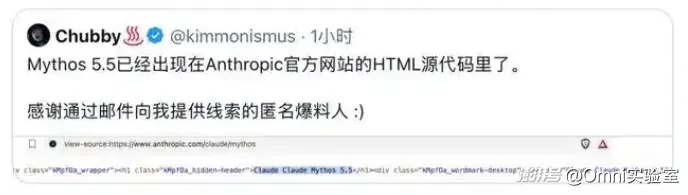
虽然相关内容很快被删除了,但还是引起了讨论。
普通用户未来能用到的,是与之同源的通用版本,叫Fable 5.5。
从已经公开的数据来看,这个模型有几个硬指标:100万token的上下文窗口,最大输出能达到12.8万token,定价是每百万输入token 10美元,输出50美元。
有人做过测试,让上一代模型和新模型用一句话去生成3D场景。上一代模型做出的东西像一幅立体的画,你只能转动角度去看,但里面的东西是静止的。
而Fable 5.5生成的场景里,楼房是逐渐盖起来的,昼夜在交替,甚至有火山喷发、火箭升空这样的动态过程。
据说在有的演示中,它能根据一句话直接生成一个可以走进去操作的3D游戏世界。
也就是说,它不再只是生成一张好看的图,而是真正理解了事物运转的逻辑。
三、美团 LongCat-2.5:参数不盲目求大,图的是干活快
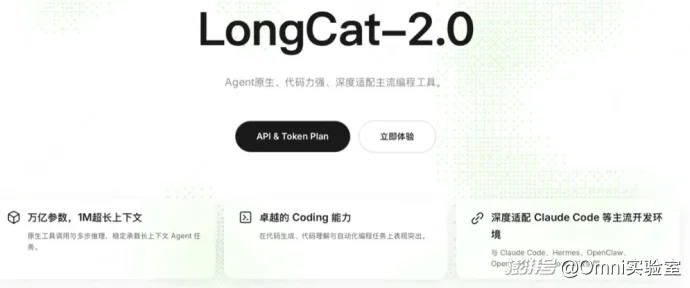
目光转回国内,11月2日,美团正式发布了LongCat-2.5模型。
这款模型在架构设计上走了一条很务实的路线。它的总参数量达到了1.6万亿,采用的是MoE(混合专家)架构。
这里可以稍微解释一下:总参数大,意味着模型脑子里装的知识足够多;但它每次处理问题时,只激活约480亿的参数。
就像一家公司有很多专家,但是遇到具体问题时,不用把所有专家都叫来,只叫几个相关的专家来开会,既保证了有足够的知识储备,又不会因为人太多而拖慢速度。
这款模型的定位非常明确,就是面向长程智能体任务的原生多模态模型。
它支持100万token的上下文,重点强化了视觉理解、写代码以及连续处理复杂任务的能力。在公开的评测中,它的代码能力(Terminal Bench v4.0)拿到了38.5分,3D代码能力(3DCodeBench)拿到了55.4分。
美团做模型的时间并不算长,但这款模型的侧重点很清晰,不追求做个无所不知的陪聊机器人,而是做一个能看懂界面、能写代码、能把长流程任务负责到底的干活工具。
总结:衡量AI好坏的标准已经变了
过去这两年,我们衡量一个AI好不好,往往是问它一个问题,看它回答得漂不漂亮,说的准不准。
但现在,我们看模型的发展方向,更加侧重于它能不能自己盯住一个目标,连续工作几个小时,中间不跑偏、不敷衍、不欺骗。
对普通用户来说,这意味着我们看待AI的态度也可以随之改变了。
也许用不了多久,我们衡量AI的标准,将不再是它陪我们聊得有多开心,而是它能帮我们把手里那些繁琐、耗时的任务,安安心心地办完。
AI从智能的陪聊助手,变成管用的工具,也是技术更新落地的另一个开始。