从零到百亿估值六年,Supabase把Postgres补成了智能体能用的样子
过去六年里,一家开源、全员远程的数据库公司把估值做到了 100 亿美元,这件事本身已经值得记一笔;更值得记的是,它现在几乎成了 AI 智能体写代码时默认绕不开的后端。
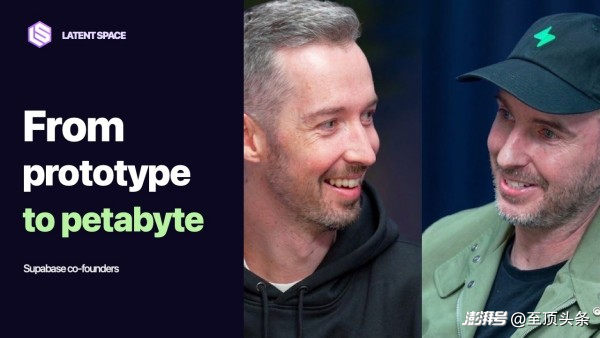
Supabase 联合创始人 Paul Copplestone(CEO)和 Ant Wilson(CTO)在公司年度客户大会 Supabase Select 前夕,接受了 Latent Space 主持人 swyx 的联合专访——这是两人第一次一起出现在同一场播客里。swyx 和 Supabase 的关系并不只是主持人与嘉宾:六年前 Supabase 种子轮融资时,他就是天使投资人之一,那也是他人生第一笔天使投资;Supabase 后来又成了 2023 年 AI Engineer 大会的第一个赞助商,如今也是 Latent Space 的第一个赞助商。
这场对话的内容围绕 Supabase Select 大会上的三个关键词展开:build、operate、scale。它们分别对应三件事——怎么让智能体更顺手地写代码和部署、怎么让智能体在运维时拿到足够的上下文、怎么把 Postgres 撑到足够大的规模。
1. 这不是专门为智能体做的,而是智能体也刚好需要的
声明式 schema 听起来是一个很技术性的改动,但它解决的问题很直接:传统 Postgres 的范式是先建表、再一轮轮 migration,状态散落在历次变更脚本里,没人能一眼看清当前的真实结构。Supabase 把 schema 的定义本身变成了可以放进 git 的声明式文件,这意味着整个数据库结构变成了一份可以被爬取、被 fork、被重新生成的"源代码"。
对智能体来说,这恰好是它工作的方式——读一份文件,理解结构,照着改。但这件事的价值并不局限于智能体。人类开发者同样苦于追踪数据库的历史变更,声明式 schema 对谁都是减负。Supabase 这套思路背后的态度很明确:不想做"只为了让智能体开心"的功能,好的基础设施应该对人和智能体一样友好。
同样的逻辑出现在 MCP server 上——给应用配一个来自 Supabase 的 MCP server,让智能体能直接理解和操作数据库,这不是噱头功能,而是把 Postgres 这个四十岁的数据库,一点点改造成能被自动化工具原生理解的样子。
2. 从 Edge Functions 的秒级上限,到挨着数据库跑的完整计算实例
Supabase 原有的 Edge Functions 产品跑在 Deno 上,有执行时长的硬限制。社区反馈一直很一致:想跑更重的任务,比如分块处理和向量嵌入这类长耗时工作,现有限制不够用。
Supabase Compute 是这次大会公布的答案。它是长时间运行、无服务器的计算实例,运行在和数据库相同的私有网络里,天然低延迟,可以直接从计算层面向数据库发起 Postgres 连接。它不再被绑定在 Deno 上,Rust、Python 都能跑,甚至可以直接在里面跑智能体本身。用一个更熟悉的参照来说,这相当于容器类型的 Lambda 函数——但这次容器就挨着数据库运行。
把计算搬到数据库旁边听起来是个很朴素的工程决定,但对需要频繁读写数据库的智能体工作流而言,延迟和网络开销的削减是实打实的。
3. 把存储引擎打穿:OrioleDB 的性能提升与专利开源
OrioleDB 是 Supabase 去年就公布过的项目,过去一年里被反复推到极限测试,以确保它经得起生产环境的检验。它是 Postgres 现有堆存储引擎(heap)的直接替代品,速度能提升到 1.5 到 2 倍,而且不需要改动其他任何东西——完全兼容现有系统,还顺带去掉了 vacuum 之类的后台维护任务,让数据库运行得更高效。
为了验证它不会丢数据,团队把 OrioleDB 跑过了 PG regress 全量兼容性测试、antithesis 的对抗性测试、TPCC 的夜间基准测试,以及 JSON 相关的专项测试。现在这个引擎以完整 beta 版发布,并且采用 Apache 2 许可证——包括随之而来的专利。Supabase 收购了这项技术、继续开发、买下专利,然后把它完全免费开放出去。这不是一个常见的开源故事,大多数公司拿到专利后不会选择这么做。
4. 每一个现有 operator 都会丢数据——Multigres 的从零重写
多节点 Postgres 集群需要一个叫 operator 的东西来管理故障切换、备份这些工作。Supabase 团队把市面上能找到的 Postgres operator 全部测了一遍,得出一个结论:在某些特定条件下,每一个都会丢数据。
这个发现直接促成了 Multigres——对整个 operator 结构的从零重写。最初的目标只是想把分片能力(sharding)带给 Postgres 社区,但做到后来,它变成了一整套操作系统级的东西。团队做了 1000 次连续故障切换测试,没有丢过一次数据,并且用各种方式反复冲击它,试图找出任何可能丢数据的场景。
Multigres 的设计思路来自 Vitess——那个最初为 MySQL 生态做分片而生的项目,由 Sugu 创建,而 Vitess 正是驱动 YouTube 和 GitHub 这类超大规模系统的底层方案。Sugu 加入后提出的第一要求是:优先做兼容性,而不是急着上分片。过去用 Vitess 分片时,用户常常得改查询语句才能适配。这次 Multigres 的重写就是为了避免这个代价——等分片功能正式发布时,用户的查询代码应该完全不用改。目前分片功能还没有正式发布,团队已经看到了早期原型,预计明年年初视平台进度推出。Multigres 本体明天将以完全开源的形式发布,企业级客户可以邀请制接入,由团队协助扩容。
Supabase 之所以把品牌语从"prototype"换成"petabyte",说的就是这件事——客户规模在变大,公司要跟上。
Postgres 从单机数据库走到能支撑分片集群,这条路走了很长时间,而 Supabase 选择把它走完的方式,不是绕开 Postgres 另起炉灶,而是一点点把它改造到能扛住今天的规模。从声明式 schema 到贴着数据库跑的计算,从更快的存储引擎到不丢数据的分片方案,这些动作串起来,其实回答了开篇那个问题:智能体之所以爱用 Supabase,不是因为它专门为智能体设计了什么花哨功能,而是因为它把 Postgres 这个四十年的老系统,改造成了一个对人和机器都足够清晰、足够可靠的基础设施。