从开源首个3D算力软件底座到“年度科创先锋”,清微智能如何成为中国新质引擎
10 月 22 日下午,第二届消费电子创新大会(CEIC2026)现场,“澎湃新闻 2026 科创先锋案例发布仪式”揭晓年度科创先锋案例,北京清微智能科技股份有限公司入选“年度先锋引擎品牌”。
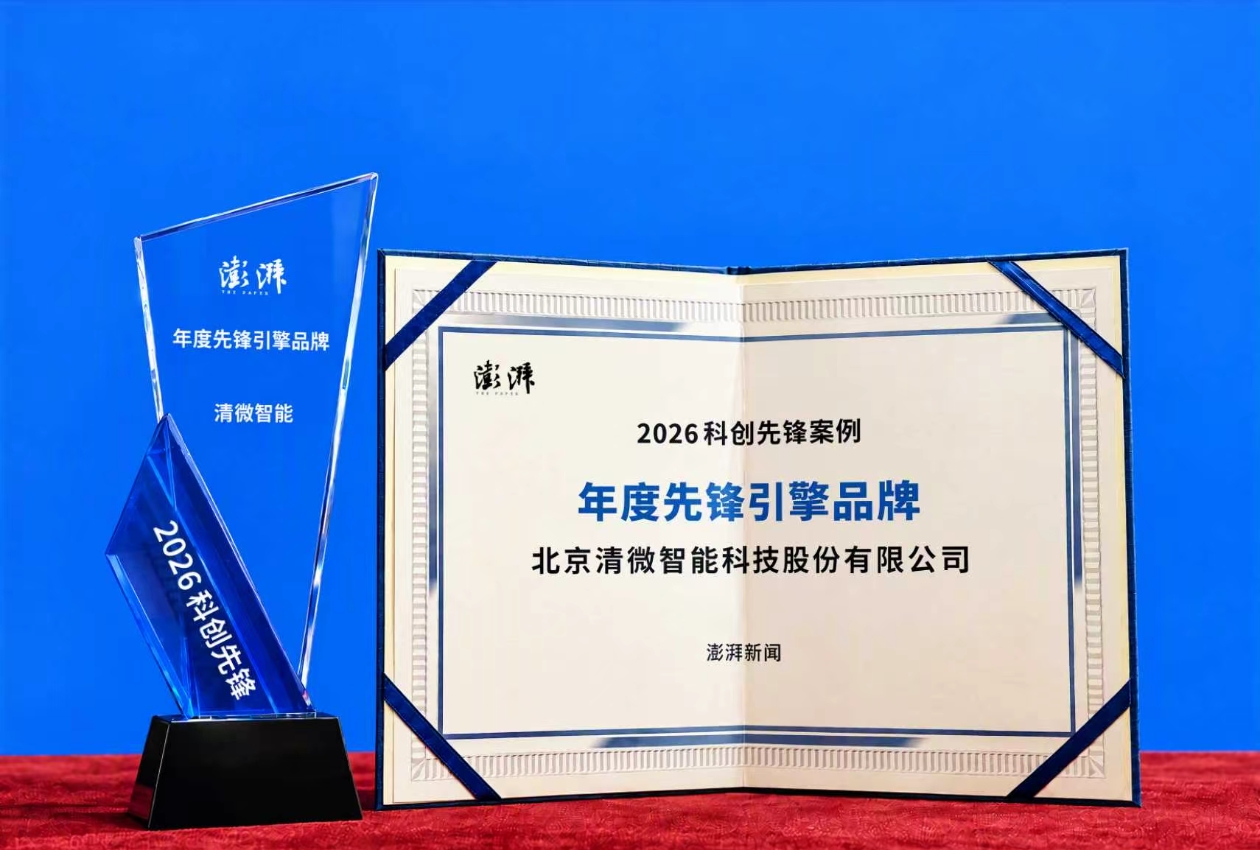
CEIC2026是汇聚全球消费电子领军企业、科研院所与产业组织的年度重点产业盛会,入选“年度先锋引擎品牌”,意味着清微智能以可重构计算驱动产业变革的实践,获得行业与媒体的双重认可。
今年以来,清微智能在科技创新领域频频落子。升级可重构计算3.0技术体系,发布全栈自研的RAISA软件栈。在WAIC上,首发REX81 Supernode 4K超节点系统完整形态;在前沿探索方面,联合东方星链推出全球首个可重构芯片太空智能体。
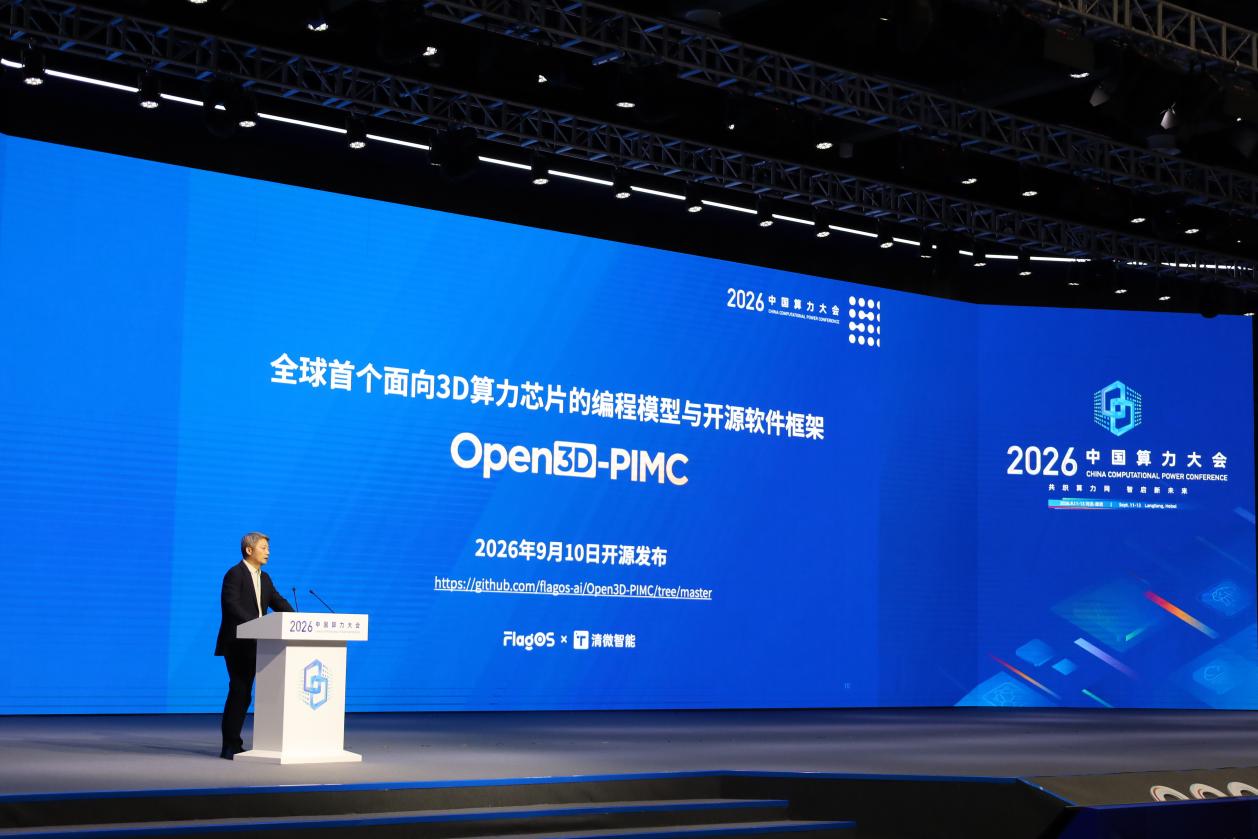
尤为值得注意的是,在今年9月的中国算力大会上,清微智能联合北京智源人工智能研究院正式开源发布Open3D-PIMC——全球首个面向3D算力芯片的编程模型与开源软件框架,全部代码已对外上线开源社区,成为国产自主AI软件栈众智FlagOS面向下一代3D算力芯片的主要解决方案之一。澎湃记者了解到,中国多家芯片公司的3D算力芯片量产在即,但统一编译层却尚未就位,Open3D-PIMC补上了这一空白。清微智能正以可重构芯片为底座,从硬件供应商转向下一代算力芯片的规则定义者。
率先布局3D算力芯片软件生态
近年来,底层基础软件开源建设愈发受到产业重视。开源已成为基础软件领域技术演进的主流模式,为产业协同创新提供重要实现路径。依托开源模式,行业主体可开展跨主体技术协作,加快技术迭代效率。
国内AI芯片软件生态仍存短板。部分厂商则分散建设各自软件栈,“一芯片一软件栈”的开发模式导致重复研发、生态割裂。随着3D算力芯片进入量产前夜,配套编译器缺失将制约硬件性能释放。
Open3DPIMC的出现,正是在这一关键窗口期做出的前瞻性布局。9月10日,清微智能联合北京智源人工智能研究院开源发布Open3D-PIMC。据了解,它首次建立了面向3D算力芯片的统一编程模型:开发者仅需定义数据分布、任务划分逻辑,框架自动完成算法向硬件的适配与优化。框架兼容多厂商硬件,各家芯片私有指令集、微架构能力以插件形式保留,兼顾开源共建开放性与企业核心技术权益,从根源上破解了“一芯片一软件栈”的碎片化困境。
更重要的是,Open3DPIMC融入的众智FlagOS生态,已具备了规模化支撑多元算力的实战能力。截至目前,FlagOS已实现对20家芯片厂商30多款AI芯片的适配,覆盖GPU、NPU、GPGPU、DSA、RISC-V AI、ARM等多元架构,成为全球支持芯片种类最多的开源AI技术栈。在应用层面,FlagOS实现“一次编写,多芯片运行”,对于主流大模型最新版本,能在一天内完成多芯片同步适配。
在自研软件生态方面,清微智能也在加速落子。今年7月,清微智能正式发布全栈自研的RAISA软件栈已支持超1000个主流算子和200余个大模型高性能适配,DeepSeek-V4、GLM-5.2、腾讯混元Hy3等主流大模型均能做到Day-0适配,成为可重构架构进入主流AI生态以及千行百业的关键枢纽。
正如清微智能董事长兼CEO王博所言:“过去我们讲国产算力,更多是补硬件的短板;现在到了要定标准、建生态的时候。”
进入可重构计算3.0时代
在开源创生态的背后,是清微智能的硬件底气。
清微智能成立于2018年,核心团队来自清华大学微电子所,成立之初即选择可重构计算这一非GPU技术路线。不同于 GPU 的固定计算架构,可重构计算的核心是“软件定义硬件”,不依赖最先进制程,通过重构计算架构,让同一颗芯片在不同任务下“变身”,从而输出灵活多用、高性价比的算力。
2019年,第一颗国产自研创新架构AI芯片实现量产。截至2026年上半年,根据行业研究机构IDC2026统计,清微智能AI芯片出货量位列国产商用AI芯片第一梯队,并入选 2025年《财富》中国科技50强。
今年,这条清微智能的技术路线在架构和集群两个维度同时迎来升级。
在架构方面,WAIC上,清微智能首次系统展示可重构计算3.0技术。据了解,可重构计算3.0技术由可重构计算架构、三维存算融合和算力网格组成,分别对应AI计算中的效率墙、存储墙和互联墙。三者的组合,形成了清微智能技术路线的优势:既保留接近专用芯片的计算效率,又能适应不同模型;既提高单颗芯片的访存效率,又把扩展能力延伸到千卡集群。
尤其是其中的3.5D存算融合技术方案,受到行业关注。清微智能通过Chiplet技术将可重构计算芯粒与DRAM存储芯粒进行高密度集成,将部分信号传输距离从毫米级压缩到微米级。
传统二维芯片的数据传输更像一条“单车道”,存算融合则相当于将道路扩展为立体的“四车道”,有效缓解“内存墙”问题,提升带宽并降低数据搬运延迟。
集群方面,今年6月,清微智能在智源大会首发REX81 Supernode 4K可重构超节点系统。同时推出TX81计算模组、REX1032 高性能智算服务器,完成从芯片到模组、服务器、集群的全栈硬件布局。
其中,REX81 Supernode集成4096颗TX81芯片,通过2D-Torus拓扑和芯片直连通道组成千卡量级系统,算力突破每秒500千万亿次(500PFLOPS),通过创新的算力网格互联架构,将节点间互联成本降低约90%。
此前,以TX81芯片为核心、REX1032服务器为载体的算力产品,已批量部署到全国各地数据中心,构成清微智能的全国算力网络。
清微智能在全国的算力部署及在建规模已超5000P,产品已陆续在全国近20个智算中心及千卡级集群中大规模应用,覆盖北京、河北、浙江、安徽等十余个省市。
在“东数西算”工程中的中国联通呼和浩特云数据中心等标杆项目中,清微提供了从芯片到集群的全栈算力支撑。
多元部署,一颗芯片的“上天入地”
基于完备的软硬件体系,清微智能在太空算力、AI探矿、AI造芯等多个领域实现落地应用。
在太空领域,清微智能与东方星链共研全球首个可重构太空计算智能体。依托清微独有的算力网格技术,该智能体内的每颗芯片既是计算节点也是网络路由节点,具备动态切分多任务并行、故障自愈、分批发射在轨生长三大优势,可实现星载算力和网格通信100%自主可控,大幅降低天基互联运营成本,为我国太空计算基础设施自主化开辟全新路径。
目前,可重构芯片太空智能体已经通过15G重力极限测试与抗辐照验证,计划2026年下半年发射入轨,完成全球首次可重构芯片在轨技术验证,2030年前后建成全球首个可重构芯片太空计算体系。该技术可全面支撑应急防灾预警、自然资源与生态监测等多领域实景需求,推动航天算力从传统“数据回传”模式升级为“星上原生决策”新模式。
在地质勘探领域,清微智能联合蓝星智探科技有限公司、曜疆人工智能研究院推出AI探矿方案,解决了探矿中各类“不规则数据”分析难题,为地质勘探行业带来了革命性的效率跃升。
在芯片设计领域,清微智能将可重构算力应用于芯片设计与EDA工具链优化,助力芯片设计流程智能化升级,进一步拓展了可重构算力的产业应用边界。
从软件栈到开源生态,从超节点到太空智能体,清微智能正在把“可重构”从一条技术路线,铺展为覆盖软硬、贯通天地的完整版图。可重构芯片也正在从一颗能"变身"的算力部件,成为驱动下一代算力软件生态和千行百业落地场景的新质引擎。