OpenAI两周发了百篇数学论文:数学成果的第一发布者,正在从大学变成AI公司

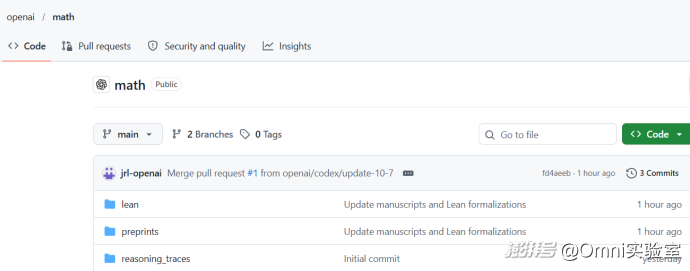
10月7号凌晨,OpenAI在GitHub上干了个大的,一口气发布了722篇数学手稿。
覆盖数论、代数几何、理论计算机科学、数学物理等17个方向。
这么多手稿都是他们一个还没发布的内部模型写的,而且都有一个特点手稿的文件夹名都以日期结尾,几乎全部集中在9月23号 到10月5号之间。
其中9月23号和24号两天,每天都有将近200篇。
两周,722篇、17个数学方向,看到这几个关键词后不由觉得这效率太可怕了。
一、先看一道题,你就知道这事有多重
希尔伯特第十问题,于1900年提出。
简单说,就是数学家想找一个万能公式,你随便给它一个方程,它自动告诉你这个方程有没有解。方程长什么样呢?就是像 x2+y2=z2这种。
几个变量加加减减、乘乘除除,等于一个数。数学家想找的,就是一个能判断这类方程到底有没有解的通用办法。
1970年,数学家马季亚谢维奇证明了这样的万能公式不存在。
其实“不存在”这个答案本身就是一个重大成果。但问题到这里没有结束,他证明的是,当“解”必须是整数(比如1、2、-3这种)的时候,万能公式不存在。
那如果允许“解”是分数呢?比如二分之一、三分之二这种?结果仍然无人知晓。
就这么一个字的区别,整个问题又卡住了五十多年。
这次OpenAI给出了一个答案,其中的第004号手稿说,答案还是否定的,也就是就算把“解”换成分数,万能公式照样不存在。
再看第003号手稿,准黎曼猜想。
数学里有一个函数,名字叫zeta函数。这个函数很特别,它的取值跟素数的分布有很深的关系。
数学家发现,zeta函数在某些特定的输入值下会等于零,这些输入值就叫“零点”。
黎曼在1859年提出一个猜想:所有这些有意义的零点,都排在一条竖直的线上。这条竖线在横坐标0.5的位置。
你可以把这条线想象成一条很窄的通道。黎曼说,所有零点都在这条通道里,没有一个跑出去。
数学家想证明这件事,但一百多年了,没人做到。
于是他们退一步,不证明所有零点都在0.5这条线上,先证明某个区域里没有零点。
比如,先证明横坐标大于0.99的那片区域里,一个零点都没有。这样至少能把零点的活动范围缩小一点,离最终目标近一步。
但这个退一步的证明也很难
一百多年里,数学家一点一点把“没有零点”的区域从横坐标1往左推,推到了0.99附近。
0.99离0.5还有很远,但已经推不动了。每往前挪一点点,都极其困难。
OpenAI的第003号手稿说,他们一下子推到了0.875。
0.875和0.99之间差了多少?在这个问题里,差距相当于之前一百年所有进展加起来的好几倍。
二、问题来了:怎么验证?
722篇手稿里,只有162篇的主结果附带了Lean证明,占比大概22%。OpenAI自己在发布说明里也承认,没形式化的结果可能存在问题。
Lean证明你可以把它理解成一个专门检查数学证明的计算机程序。数学家把证明写成计算机能一步步读的代码,Lean就负责检查每一步逻辑对不对。
但这里有个问题~
Lean就像一个语法检查器。它能告诉你这句话语法没错,但它不能告诉你这句话是不是真的,也不能告诉你这句话有没有回答你想问的问题。
有数学家对《科学美国人》表示,除非他们发布模型、人们能复现结果,否则你应该把任何关于单智能体一次解决问题的说法视为未经验证。我们应该要求他们出示收据。”
数学研究者Dmitry Rybin举了个例子。
他读OpenAI关于平面色数≥6的证明时,发现模型不知从哪里得出了<任何K-着色等价于弱可测K-着色>的结论,完全看不懂来源在哪。
10月6号刚发的一篇预印本论文也专门讨论了这事,把自然语言证明翻译成计算机代码的过程,本身可能就不忠实于原来的意思。
Lean说你的代码没bug,不等于你的代码实现了你想要的功能。这区别在数学里是天壤之别。
三、抢发这事,从个例变成了系统性问题
验证机制的局限只是一半。另一半,是学术信用体系的冲击。
今年9月,OpenAI说他们的内部模型组织了一万个AI智能体,用了88个小时,证明了一个叫Navier-Stokes方程的数学难题。
这是数学界七个最难的问题之一,悬了一百多年。
但纽约大学的一位数学家Tristan Buckmaster马上公开说,他和Anthropic的研究员之前一直在做相近方向的工作,而且已经用Lean完成了验证。
他指控OpenAI在知道有人快得到答案之后,部署大规模算力抢先给出了证明。
这次722篇的批量发布,把抢发从个例变成了系统性问题。
数学研究的优先权归属,在AI批量产出、模型不对外发布、结果不可复现的情况下,变成了一个没法仲裁的问题。
学术信用体系的基础就是“优先权”就是谁先发表,谁获得承认。当发布速度从年变成两周,而验证还是得以年来算,这个系统就会出问题。
四、谁来提问题?
这次发布有个容易被忽略的背景。
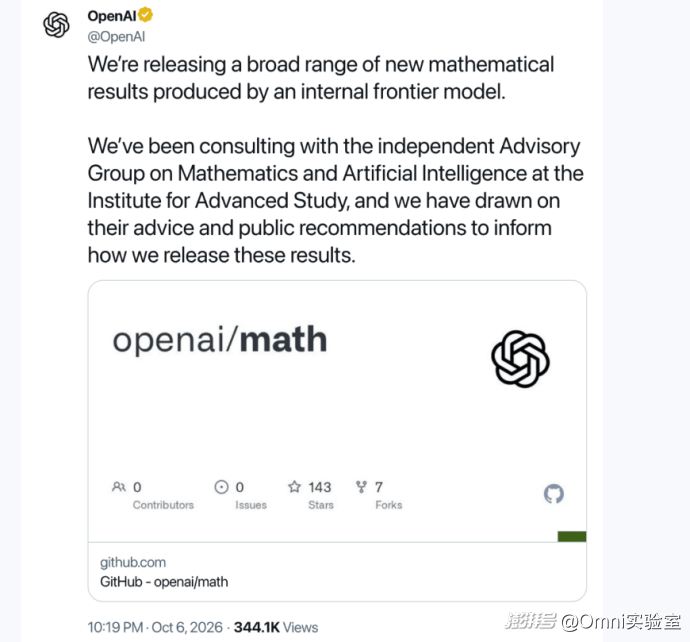
9月下旬,普林斯顿高等研究院下面有一个叫AGMAI的咨询小组,发了一份建议。核心意思是:AI实验室应该走正规学术渠道发布成果,公开模型信息和算力成本,别把数学成果当成推销模型的广告。
OpenAI在发布说明里说“借鉴了AGMAI的建议”。但AGMAI在10月7号晚上的声明里明确表示:我们的建议不代表认可这些结果,也不代表认可OpenAI获取结果的方式。
声明里有一句话值得反复读:“数学研究的未来不能仅仅局限于理解AI实验室的成果,数学家必须能够提出自己的问题。”
AGMAI的声明,本质上是在争一件事:提问权。
如果AI实验室决定了哪些数学问题值得研究,而数学家只能被动验证这些结果,那数学作为一门由人类好奇心驱动的学科,它内在的动力就被外部化了。
菲尔兹奖得主陶哲轩之前把这种情况形容为对数学的露天开采,还说好的问题就像不可再生资源。多伦多大学数学家Daniel Litt在8月的一次演讲里,标题直接叫《数学的终结》。
最后
说一个我觉得最值得想的问题。
假如上面说的这些结果最后全被验证为正确,学术秩序受到的冲击就会消失吗?
我觉得不会。
重点不是AI能不能做数学,而是数学知识的第一发布者从大学和研究所变成了AI实验室。
这种转移一旦发生,验证速度跟不上生产速度,优先权没法仲裁,研究方向被外部定义,学术共同体的自主性就会遇到一个结构性的挑战。
陶哲轩说AI在露天开采数学,好的问题像不可再生资源。这话听着有点悲观,但可能还没到那个地步。
毕竟,AI现在做的,是用模型去解那些人类早就提出来的老问题。
真正定义一个新方向、问出一个从来没人想过的问题,这件事目前还是人类在做。
但能持续多久,谁也不知道。