牛津大学/哥伦比亚大学团队:从“智能”谈起——再定义神经科学和AI的关系

生命科学
过去十年,人工智能的迅猛发展重新激活了一个经典问题:智能究竟是什么,它又是如何产生的?
早在2016年,神经科学和AI研究迎来了第一个交汇点。两篇具有里程碑意义的论文指出神经科学与认知科学能够为构建 AI 提供有益的路线图:DeepMind 团队的论文在某种意义上理所当然地更看好深度学习,而 MIT 团队则仍较多地依附于先天主义传统,认为深度网络过于依赖数据,需要更强的归纳偏置。不过,包括迁移泛化能力等,基于自然大脑与心智研究中的熟悉议题,两方提出了一系列高度重叠的AI 未解挑战。
站在今天的视角,许多曾被视为长期瓶颈的这类挑战已被大模型显著推进,但新的图景也随之浮现。2026年9月18日,牛津大学实验心理学系Christopher Summerfield和哥伦比亚大学理论神经科学中心Kimberly Stachenfeld在Cell Press细胞出版社旗下期刊Neuron发表题为“The recipe for intelligence in natural and artificial systems”的评论文章。该文章试图回答两个彼此关联的问题:过去十年的AI突破究竟揭示了哪些关于智能的新原理,自然系统与人工系统之间又是否正在显现出一套共享的计算逻辑。与此同时,作者也将目光投向尚未解决的难题,为重新理解智能研究的下一阶段提供了框架。
作者认为,过去十年推动AI取得突破的关键进展是Transformer及其支撑的大规模生成模型。通过在海量语言与代码数据上进行预测学习,LLM展现出强大的知识获取、结构化生成与推理能力,这促使人们重新审视“理解必须依赖感知和行动”的传统看法。
在关系推断取得的突破上,作者注意到快速联想过程比单纯的循环维持更适合支持抽象关系和组合推断。大模型借助自注意力与规模扩展,已经能够学习语义、句法和高层叙事中的稳定抽象;而从神经科学看,这种机制又与海马及内侧颞叶中的联想记忆原则形成呼应,如键值索引、模式补全和赫布式快速编码。这说明,Transformer虽然并不忠实模拟生物时间过程,却在计算原理上接近大脑处理关系信息的核心方式。
在即时学习能力的提升方面,作者指出高样本效率学习并不必然依赖显式符号操作,而可以通过“学会如何学习”的机制实现。大规模模型在多样化训练中发展出上下文学习能力,使系统无需更新参数,也能在当前输入中快速归纳规则并迁移到新问题。比如,Transformer能够从少量示例中提取关系模式、句法规则和任务结构,并对未见情境作出零样本推断。与此同时,神经科学研究也表明,大脑会显式编码刺激与任务所处的嵌入空间,如数量、空间和抽象关系的几何结构,从而支持对新经验的快速泛化。两者共同说明,灵活应对新异性依赖于对“内容”及其“结构”的同时表征。
从规划与推理能力的跃升角度,作者认为复杂推理并不完全依赖在线搜索,许多规划问题可以借助预先习得的语义结构被直接化简。目前,大模型能够通过大规模预训练积累丰富语义知识,并在思维链、工具调用和强化学习后训练的支持下,把语义检索转化为多步求解。LLM常能凭借对常识、偏好和任务语境的把握,快速生成近似于规划的答案;而在更复杂的数学和推理任务中,外部化中间步骤、调用代码与验证机制又显著提升了表现。两者都说明,强推理往往建立在丰富语义、外部支架与显式训练共同作用的基础之上。
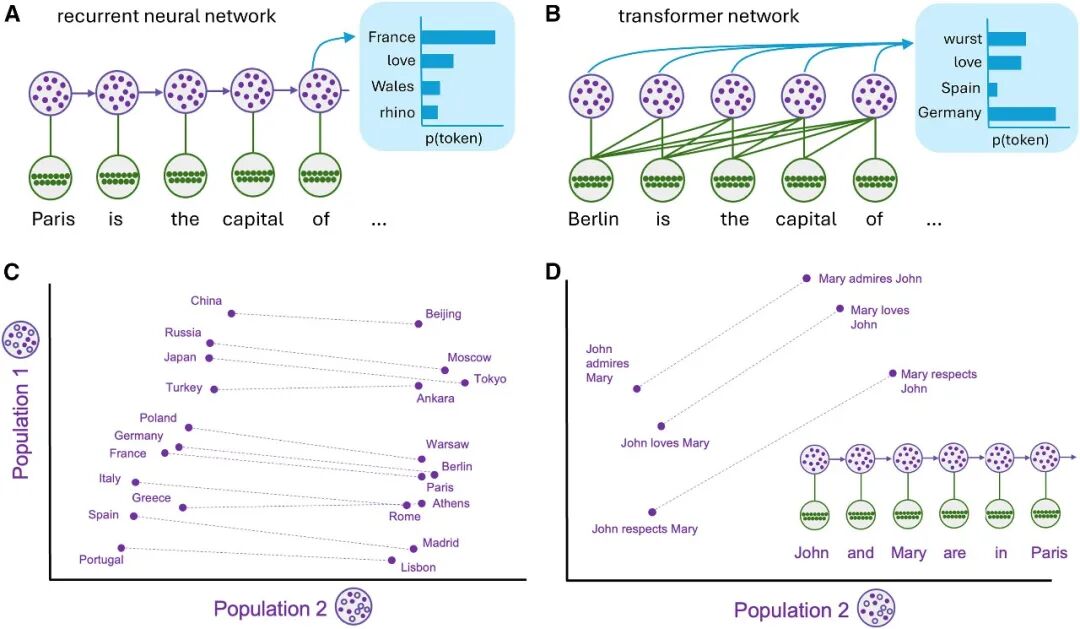
图1. 人工智能模型中的语言表示
尽管在构建 AI 方面已经取得了显著进展,但仍然有许多工作有待完成。
首先,当前AI仍然缺乏持续学习的能力:模型在部署后通常停止参数更新,因而难以把新经验稳定写入长期记忆。现有主流思路主要包括扩展上下文窗口和引入检索增强生成,但前者成本高且检索不稳,后者仍未真正解决“存什么、存多久、如何取回”的记忆难题。作者由此提出,持续学习的关键不只是扩大容量,而是建立短期经验与长期存储之间的有效整合机制。生物系统中的记忆巩固过程:经验通过重放与优先化选择,被逐步转化为稳定知识,可能提供有益的借鉴。
第二,作者指出AI缺乏稳定自我监控能力,这使模型虽能执行复杂任务,却常出现信心失准、目标漂移和长期行为不稳定等现象。可靠的长期目标行为不仅需要规划外部世界,还需要形成对自身状态、能力和承诺的表征。在生物体中,前额叶外侧区域负责执行,内侧区域负责监测、控制和维持目标投入,“动机”和“行为”倾向于分离。类似地,当前主流改进思路主要集中在智能体外层的harness设计,通过控制回路、资源分配和停止机制来约束任务执行,在一定程度上弥补模型内部自我监控的不足。
第三,当前AI在规则明确、结果可验证的形式化任务中表现突出,却难以胜任充满噪声、歧义与不确定性的开放环境,也因此在创造性发现上仍显不足。作者认为发现能力来自与世界的持续互动。开放环境中的问题缺少清晰反馈,往往需要试探、调整和发散性搜索,而这正是当下大模型最薄弱之处。现有研究思路主要转向更具交互性的框架,如强化学习、主动推断和赋能理论,强调通过行动—环境循环获取新信息。未来的启发则可能来自具身探索与多智能体协作所形成的累积创新机制。
总体而言,过去十年,大模型在知识获取、关系推断、快速泛化和复杂推理上的进展表明,自然智能与人工智能正在显现出若干共享的计算原则,尤其体现在生成式学习、联想记忆、结构表征和预计算语义等方面。作者认为,神经科学可以为AI解释已有突破、识别关键缺口和设计下一代架构提供理论参照。与此同时,通向更完整智能的道路仍未走完,持续学习与记忆整合、自我建模与元认知、开放环境中的探索与创造,仍是亟待深入研究的关键方向。
相关论文信息
论文原文刊载于Cell Press细胞出版社
旗下期刊Neuron
▌论文标题:
The recipe for intelligence in natural and artificial systems
▌论文网址:
https://www.sciencedirect.com/science/article/pii/S0896627326006434
▌DOI:
https://doi.org/10.1016/j.neuron.2026.08.013
原标题:《牛津大学/哥伦比亚大学团队Neuron:从“智能”谈起——再定义神经科学和AI的关系 | Cell Press论文速递》