万亿参数、千万小时数据、百亿投入下,美国具身智能正加速逼近
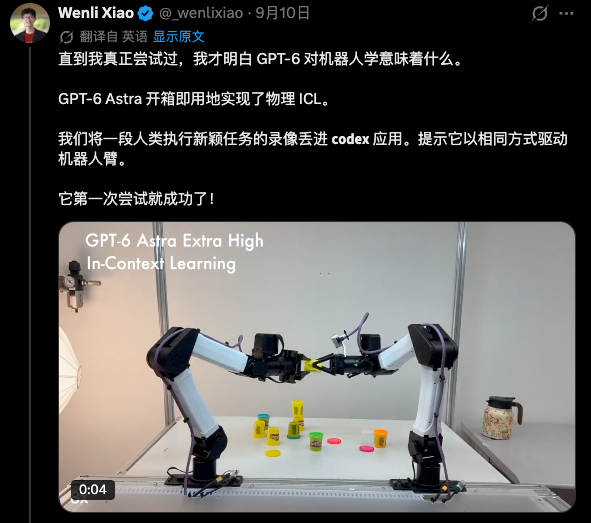
近日,一份测试报告在具身智能圈内引发了震动。这份报告首次系统验证了OpenAI最新大模型GPT-6 Astra在机器人操控任务中的真实能力边界——这项由中国科研团队完成的评测,既揭示了美国大模型在具身操控上的泛化突破,也给国内具身智能行业敲响了一记警钟:美国在具身智能“大脑”层面的突破速度,比我们想象的要快。
一个值得警惕的信号
9月12日,一份名为《GPT 6 Astra as an Embodied Policy》的研究在GitHub开源。在这项针对RoboDojo双臂操控基准的测试中,由π₀.₅控制器与GPT-6 Astra组成的混合系统,在10项核心任务中拿下62.6的平均分,远超第二名64%。
而该研究来自一名银河通用研究员——银河通用创始人及CTO王鹤教授的博士生。这意味着,一家中国具身智能头部企业,率先以严谨的对比实验,验证了美国大模型在机器人操控领域的真实水平。
万亿参数模型的零样本泛化:GPT-6强在哪里
研究报告中最值得关注的发现,不是“GPT-6有多强”,而是它在哪里强、为什么强。
这份测评是怎么做的
研究团队在RoboDojo仿真环境中选取了10项双臂操控任务,每个任务跑5次,混合策略和直接控制两组对齐了场景与种子。关键设计在于两种架构的对比:
Direct模式(GPT-6 Astra Direct):Astra 直接作为策略,根据当前观察判断接下来该怎么做。
混合模式(π₀.₅ + GPT-6 Astra):π₀.₅和GPT-6 Astra结合。每个决策时刻,π₀.₅先生成50步候选动作。GPT-6 Astra看同一份画面、执行历史,还有候选动作对应的双臂轨迹,然后选择沿用π₀.₅的输出或GPT-6 Astra模型进行末端位姿修正。
核心思路就是让π0.5提供物理空间交互及动作先验,GPT-6做审核和修正。需要明确的是,π0.5是一个基于物理空间交互及动作先验的大模型;GPT-6则是图文大模型,偏语义理解。两者分工明确:GPT-6负责“做什么、对不对”,π0.5负责“在物理空间里怎么做”。
在性能上,报告给出了一个很直接的对比:
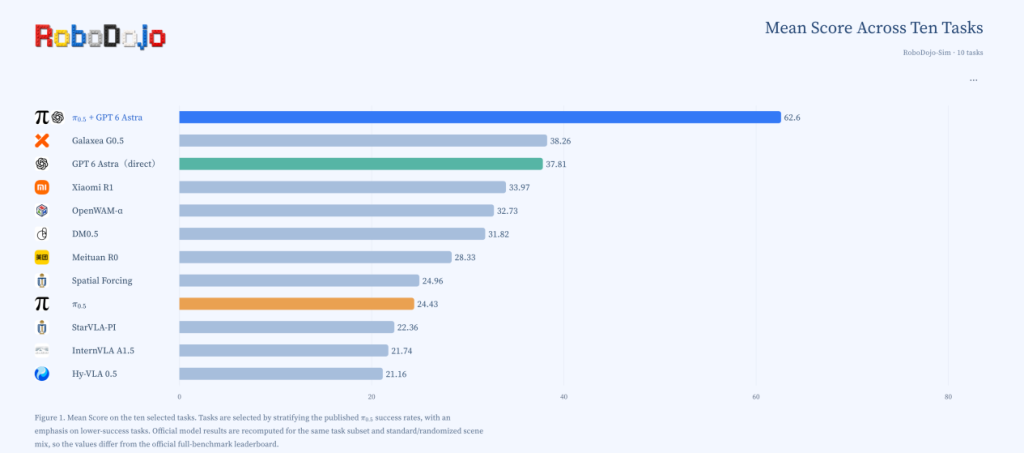
结果很清晰。混合模式拿下48%成功率和62.60平均分。Direct模式只有26%成功率和37.81分。
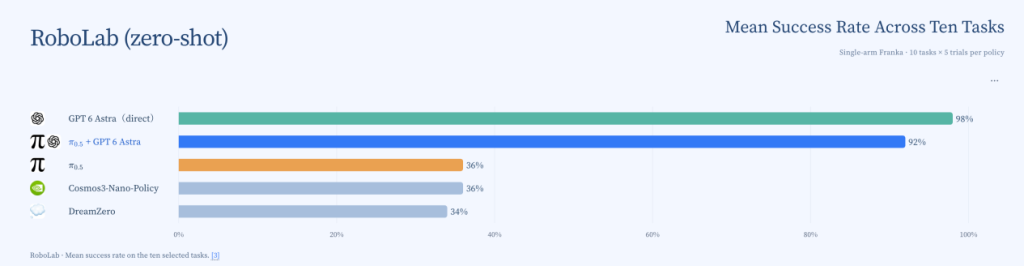
RoboLab补充评测中,GPT-6 Astra Direct在50个episode中成功49个,成功率98%;而π₀.₅ + GPT-6 Astra只成功46个,成功率92%。π₀.₅则是18/50,成功率36%。
核心发现:数据规模驱动的泛化突破
第一,万亿级数据训练的泛化能力,在具身任务中展现出压倒性优势。
语义类任务(按语言分类、模仿排序、排出最大数字) :π0.5几乎零分(0.60、1.60、2.29),混合架构直接拉到38-53分。这些题难在“想”——你得读懂指令里哪个类别对哪个篮子,得记住刚才示范的顺序,得知道9要摆在7前面。一个靠模仿轨迹长大的VLA,最难学的就是这些,GPT最擅长的也是这些。
接触类任务(搭塔、麻将杠牌) :混合架构64和40分,GPT自己上手只有12分和0分。需要手感的地方,GPT做不好。
柔性物体任务(叠衣服) :π0.5只有29.12分,混合架构100分。GPT能帮π0.5纠正方向。
简单任务(瓶子入桶) :π0.5本身就有79.93分,混合架构100分。
GPT-6 Astra采用Symphony+MoE混合专家架构,总参数规模达5-6万亿,推理时仅激活约10%的专家模块。相比之下,当前主流具身模型的参数规模通常在百亿级别——两者相差2到3个数量级。该模型训练动用超10万块GPU的Stargate超算集群,上下文窗口达105万token,原生统一多模态,文本、图像、音频、视频在底层同一编码空间处理。
这表明,在大规模数据的训练下,大模型能够实现超强的语义理解、视觉感知和泛化能力突破。报告中的数据进一步印证了这一判断:GPT-6在50条混合轨迹中,实际干预动作的比例仅为14.4%,其余85.6%的动作由π₀.₅控制器完成。GPT的价值,恰恰体现在它能够凭借超强的语义与视觉泛化能力,在关键节点上做出正确的判断和纠偏——这正是一个经过大规模数据训练的大模型所应具备的能力。
值得一提的是,混合架构记录的token用量还比独立控制减少了44.8%,降低了GPT-6 Astra逐段构造低层动作的需求。这说明混合架构不仅成功率更高,token消耗还比Direct更少——这是一个反直觉的结果:加了一个模型,反而更省token。
第二,泛化能力的优势已被验证,但物理世界的“怎么做”,仍需具身智能来回答。
GPT-6在搭塔、杠牌等需要精细力控和接触稳定性的任务上,自己上手仅得12分和0分;反而是一个经过微调的端到端VLA表现更好。这说明,语义泛化能力不能替代物理交互能力。π0.5之所以能在动作先验上提供有效支撑,得益于其在物理交互数据上的训练积累;而它在RoboLab上zero-shot仅36%的成功率,恰恰说明数据规模不足时,动作先验的质量会显著下降。具身模型的数据不够,泛化能力就上不去。
在语义理解、任务规划、指令记忆、视觉感知等任务上,GPT-6的介入将端到端模型的得分从个位数拉升至50分左右。而在搭塔、杠牌等需要精细力控和接触稳定性的任务上,GPT-6自己上手仅得12分和0分;反而是一个经过微调的端到端VLA(视觉-语言-动作模型)表现更好。
这说明,物理世界的智能必须依托海量高质量的仿真及真机数据来训练,而大模型在语义和视觉层面的泛化能力,正是得益于数据规模的持续扩大。
最值得警惕的:OpenAI的投入规模
美国正在将大模型的语义与视觉泛化能力快速延伸至物理世界,而这一层面的差距,可能比本体硬件层面的差距更难追赶。
2026外滩大会上,有从业者指出:从2025年初起,OpenAI和Anthropic便开始大量采购机器人数据,并通过小规模数据工厂开展采集。据业内人士分析,OpenAI通过数据采集中心购买的具身数据累计已达上千万小时,涵盖各类具身操作场景;在具身模型训练上的数据、算力资源投入累计超过百亿人民币,这一规模已超越中国任意一家具身公司的投入。其战略意图清晰:打造具身领域的ChatGPT。
OpenAI自2025年2月起在旧金山设立机器人实验室,团队规模已超百人,通过远程操控Franka机械臂执行烤面包、叠衣服等家务任务,以“有效功能性数据”的小时数作为绩效评估标准。实验室规模到2026年已扩大了四倍多。2026年6月,Sam Altman正式宣布成立OpenAI Robotics,明确表示“一定会做人形机器人”。与此同时,OpenAI正筹备IPO,预期上市估值超1万亿美元——巨额资本正在加速涌入具身智能赛道。
中国如何应对:以闭环打高投入
面对这一态势,中国具身智能产业需要冷静研判、果断行动。
当前,具身智能正处于从实验室走向产业深水区的关键阶段。行业内部出现了一些值得关注的现象,单纯聚焦于短期,不仅无助于行业进步,反而会错失宝贵的发展机遇和创新资源。
中国必须加大投入,否则将已经初步建立的领先优势将失去。 美国在具身数据上的百亿级投入和千万小时级数据积累,不是靠个别企业的力量能够对冲的。具身智能是典型的长周期、高投入赛道,需要同时扛起“大脑大模型、小脑运控、本体硬件、真机数据”四重研发,单靠产业资本和地方政府基金难以支撑千万小时级数据、万卡级训练、万台级量产。
以举国体制加速全链路闭环,是中国具备的独特优势。 2026年政府工作报告已明确提出,发挥新型举国体制优势,全链条推进关键核心技术攻关,培育发展具身智能等未来产业。中国已在武汉等地建设机器人训练中心,每天可产出约100小时可用数据,到2025年底已宣布超过40座国有或地方政府支持的机器人数据中心,其中约24座已投入运作。下一步,关键在于打通“硬件-数据中心-模型-落地”全链路:在硬件层,依托国产GPU实现从合成数据生成、基模训练到仿真评测的全流程支撑;在数据层,加快建设标准化、规模化的具身数据中心,统一数据采集规范和标注体系;在模型层,支持头部企业构建专用具身大模型;在落地层,以真实场景需求牵引技术迭代,形成“数据飞轮”的正向闭环。
与其在舆论场上互相攻讦,不如在技术能力、真实作业数据、应用场景上展开竞争。政府应鼓励行业健康有序发展,扶持具备全栈核心技术能力的企业加快实现通用具身智能技术。行业内部更应强化产业链协同,严禁短视的互相拆台、恶意诋毁和低价内卷。
结语
这份来自中国科研团队的评测报告,价值不在于证明谁更强,而在于用事实印证了一个关键判断:大规模数据训练下,具身智能在语义理解、视觉感知等层面的泛化能力正在快速突破。GPT-6 Astra在上千万小时具身数据和百亿级投入支撑下展现的零样本泛化能力,也让我们清晰看到了美国“具身ChatGPT”战略的推进速度。
真正值得警惕的,不是美国的大模型能力本身,而是我们是否愿意正视这一趋势,并在数据基础设施和核心技术上持续投入。 中国拥有全球最完整的硬件供应链和最大的机器人部署场景,这是我们的独特优势。但优势不会自动转化为胜势——必须以举国体制加速打造硬件-数据-模型-落地的全链路闭环,以专用具身模型的效率优势对冲通用大模型的规模优势,以真实场景的数据飞轮构筑长期竞争壁垒。
“在国际竞争对手还虎视眈眈的今天,行业不应内卷,而应一起携手站在更高的国家战略高度。”这是业内人士的呼吁,也应当成为行业的共识。